ChatGPT나 Claude로 칼로리를 기록할 수 있을까요? 연구가 말하는 것
네. ChatGPT와 Claude는 알려 준 내용으로 칼로리와 매크로를 추정할 수 있어요. 우리가 찾은 연구에서 ChatGPT와 Claude 모델의 칼로리 오차는 입력에 따라 약 14%에서 36%였어요. 채팅만으로는 날마다 믿을 만한 기록을 남길 수 없어요. 그러려면 설명에 분량을 적고, 숫자를 보관할 채팅 바깥의 장소가 필요해요.
핵심 요약
- 한 연구는 요리 195개에 대해 ChatGPT-5를 조사했어요. 사진만으로는 칼로리 평균 오차가 30.51%였고, 사진과 재료 전체 목록을 함께 주었을 때는 13.92%였어요.
- 정보를 더 준다고 항상 나아지지는 않았어요. 사진 없이 재료 목록만 준 경우는 18.05%로, 사진과 목록을 함께 준 경우보다 나빴어요.
- 네 가지 입력 조건 모두에서 단백질, 탄수화물, 지방은 칼로리보다 크게 빗나갔고, 그 정도는 1.37배에서 1.77배였어요.
- 같은 질문을 다시 하면 답이 달라져요. 2023년 연구에서 다섯 번 실행한 답의 평균 편차는 4.74%에서 6.19%였어요.
- Claude 모델을 포함한 연구는 두 편을 찾았어요. 몇 주에 걸쳐 채팅과 식사 기록을 비교한 연구는 찾지 못했어요.
Remembite가 맡는 부분: AI가 계산하고, Remembite가 기록을 보관해요. 어시스턴트가 보낸 식사를 저장하고, 추세를 차트로 보여 주고, 저장되기 전에 많이 벗어나 보이는 숫자를 표시해요. Claude 커넥터는 지금 사용할 수 있고, Remembite는 ChatGPT에서도 작동해요(beta, 개발자 모드 사용). 샘플 대시보드에서 화면 구성을 볼 수 있어요. Remembite가 무엇을 보관하는지 보기.
ChatGPT나 Claude로 칼로리를 기록할 수 있을까요?
한 끼라면 그렇다고 할 수 있어요. 음식을 설명하고 항목별 칼로리와 매크로를 요청하면 몇 초 만에 숫자를 얻어요. Claude의 무료 요금제는 $0이고, 채팅, 웹 검색, 대화 간 메모리를 포함해요(Claude 요금제, 2026-10-16 기준, 미국). 시험해 보는 데 유료 요금제는 필요하지 않아요.
기록을 남기는 용도라면 아니에요. 채팅은 한 주의 합계를 내지 않고, 숫자가 어디서 나왔는지 알려 주지 않으며, 같은 질문을 두 번 하면 다른 답을 줘요.
여기 나오는 모든 수치는 2026-10-16에 우리가 연 논문이나 도움말 페이지에서 가져왔어요. Remembite는 이 분야의 제품을 만들기 때문에 중립적인 입장이 아니에요.
ChatGPT의 칼로리 계산은 얼마나 빗나갈까요?
사진만 주었을 때 ChatGPT-5는 2025년 연구 하나에서 요리 195개를 대상으로 칼로리를 평균 30.51% 빗나갔어요(Rodriguez-Jimenez et al.). 같은 채팅에 분량이 적힌 재료 목록 전체를 함께 주었을 때는 13.92%였어요. 다른 2025년 사진 테스트에서는 ChatGPT-4o와 Claude 3.5 Sonnet이 각각 35.8% 빗나갔어요(Fridolfsson et al.).
우리가 찾은 연구 전체에서 칼로리 오차는 약 14%에서 36%였고, 사진 연구에서는 단백질, 탄수화물, 지방이 더 크게 빗나갔어요. 각 연구의 설정과 한계는 연구가 측정한 것에 정리했어요.
연구가 측정한 것
여기서는 네 편의 연구가 대부분의 근거를 차지해요. 연구마다 모델, 입력, 음식이 달라서 숫자를 하나의 점수로 합칠 수 없어요.
| 연구 | 시험 내용 | n | 주요 결과 | 한계 |
|---|---|---|---|---|
| Rodriguez-Jimenez 2025 | ChatGPT-5 Plus, 입력 조건 네 가지 | 요리 195개 | 칼로리 오차 13.92%~30.51% | 요리마다 한 번만 실행 |
| Hoang 2023 | ChatGPT-3.5와 ChatGPT-4, 각 5회 실행 | 음식 222개 | 10% 이내 39.2%~46.8% | 날것 음식, 2021년 지식 기준 |
| Mu 2025 | 식사 사진에 대한 GPT-4.1 mini | 이미지 505장 | 칼로리 오차 32.7% | 실험실 사진, Claude 없음 |
| Fridolfsson 2025 | ChatGPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro | 사진 52장 | ChatGPT-4o와 Claude 칼로리 오차 35.8% | 2024년 중반 모델, 반복 실행 없음 |
Rodriguez-Jimenez 2025: 질문하는 네 가지 방식
Rodriguez-Jimenez와 동료들은 ChatGPT-5(Plus, 웹 인터페이스)를 요리 195개에 시험했어요. 96개는 레시피 사이트, 74개는 SNAPMe 사진 데이터셋, 25개는 집에서 만든 요리였어요. 요리마다 네 가지 조건으로 실행했고, 실행할 때마다 채팅을 초기화했어요(Nutrients 2025;17(22):3613, 2025-11-19 발행). 논문은 채팅 인터페이스에서 temperature 같은 설정을 조절할 수 없다고 적었어요.
논문은 같은 요리를 반복 실행한 결과를 보고하지 않았어요.
Hoang 2023: 음식 222개, 각 다섯 번씩 실행
Hoang와 동료들은 성인 식단 메뉴 8개에 들어 있는 음식 222개를 영어와 중국어 번체로 ChatGPT-3.5와 ChatGPT-4에 주었어요. 프롬프트는 “영양사로서, 줄마다 계산하는 표를 그려 주세요”(우리 번역)였고, 대상은 “날것이고 익히지 않은” 음식이었어요. 항목마다 5번씩 물었어요. 기준값은 대만 식품 성분표였어요(JAMA Network Open 2023;6(12):e2350367).
에너지, 탄수화물, 지방의 평균 추정치는 영양사의 값과 유의미한 차이가 없었어요. 단백질은 차이가 있었고, 저자는 ChatGPT-4가 “단백질을 과대평가했다”고 적었어요. 저자들은 2021년 9월이라는 지식 기준 시점을 한계로 꼽았어요.
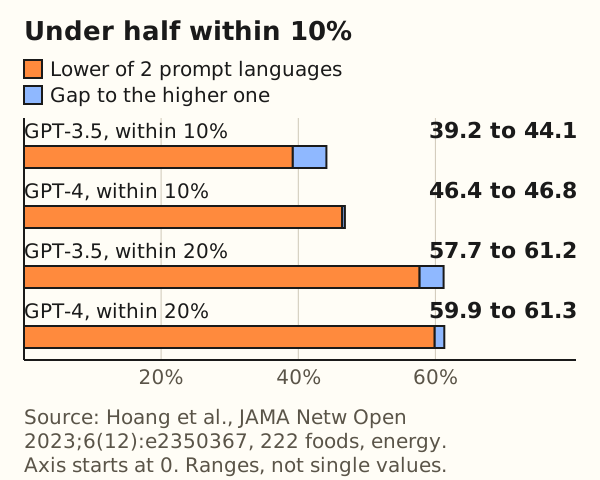
그림을 반대로 읽어 보세요. 더 강한 모델인 ChatGPT-4에서 음식의 53%에서 54%가 기준값과 10% 넘게 차이 났어요(100 - 46.8 = 53.2; 100 - 46.4 = 53.6). 약 다섯 개 중 두 개는 20% 넘게 차이 났어요(100 - 61.3 = 38.7).
Mu 2025: 사진 벤치마크
Mu, Sun, He는 고정 카메라로 위에서 찍은 Nutrition5k 식사 이미지 505장에 일곱 가지 멀티모달 모델을 시험했어요(ACM BCB 2025). 무게를 주지 않았을 때 GPT-4.1 mini의 칼로리 오차는 32.7%였어요. 지방 오차는 52.0%, 탄수화물 36.7%, 단백질 41.5%였어요. 일곱 모델 중 Claude 모델은 없었어요.
Claude가 포함된 연구
Fridolfsson와 동료들은 무게를 잰 식사를 표준 촬영한 사진 52장으로 ChatGPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro를 비교했어요(Current Developments in Nutrition 2025;9(10):107556). 칼로리 오차는 ChatGPT-4o 35.8%, Claude 3.5 Sonnet 35.8%, Gemini 1.5 Pro 64.2%였어요. 세 모델 모두 분량이 커질수록 과소 추정이 더 많았어요. 모델은 2024년 중반 버전이었고, 사진마다 새 채팅에서 분석했으며, 반복 실행 결과는 보고되지 않았어요.
2026년 Nutrients 논문은 이미지 데이터셋 세 가지에서 Claude Haiku 4.5, Sonnet 4.6, Opus 4.6을 시험했어요. 이미지만 준 SNAPMe 사진 1,463장에서 Sonnet의 평균 에너지 오차는 116.9 kcal였어요. 별도 연구에서 요리 195개를 대상으로 한 ChatGPT-5는 123.0 kcal였어요(Nakagawa and Yamamoto, Nutrients 2026;18(12):2017). 이는 한 시험에서 두 모델을 비교한 것이 아니라 두 편의 논문을 나란히 놓은 것이에요.
2026-10-16에 웹에서 Claude의 칼로리 추정을 시험한 동료 심사 논문을 찾았고, 이 두 편을 찾았어요. PubMed나 Google Scholar를 직접 검색하지는 않았으므로 더 있을 수 있어요. 어느 어시스턴트든 사람들이 몇 주 동안 식사를 기록하는 과정을 따라간 연구는 찾지 못했어요.
입력에 따라 오차가 어떻게 바뀌는가
Rodriguez-Jimenez 데이터에서는 ChatGPT-5에 무엇을 주었는지가, 논문이 바꾼 다른 어떤 요인보다 중요했어요.
| ChatGPT-5에 준 입력 | 칼로리 | 단백질 | 탄수화물 | 지방 |
|---|---|---|---|---|
| 사진만 | 30.51 | 42.58 | 41.95 | 52.88 |
| 사진 + 지방 종류와 양, 감미료, 유제품 지방, 고기 종류 | 24.35 | 40.28 | 39.00 | 43.20 |
| 사진 + 분량이 적힌 재료 전체 목록 | 13.92 | 20.85 | 23.52 | 24.16 |
| 분량이 적힌 재료 목록만, 사진 없음 | 18.05 | 30.83 | 28.50 | 29.16 |
숫자는 논문 표 2~5의 “All sources”, “Total” 행에서 가져온 MAPE(%)예요. MAPE는 평균 절대 백분율 오차예요. 요리마다 추정치와 실제값의 차이를 실제값으로 나눈 뒤, 모든 요리에 대해 평균을 내요.
계산 예시: 실제 값이 400, 600, 800 kcal인 요리 세 개. 채팅의 답은 520, 540, 640이에요.
- 요리 1:
|520 - 400| / 400 = 30%- 요리 2:
|540 - 600| / 600 = 10%- 요리 3:
|640 - 800| / 800 = 20%- MAPE:
(30 + 10 + 20) / 3 = 20%부호가 있는 오차는 +30%, -10%, -20%이고, 평균은 0%예요. MAPE는 방향을 무시하므로 과대 오차와 과소 오차가 서로 상쇄되지 않아요. 논문은 또 MAPE가 과대 추정을 과소 추정보다 더 무겁게 센다고 적었어요.
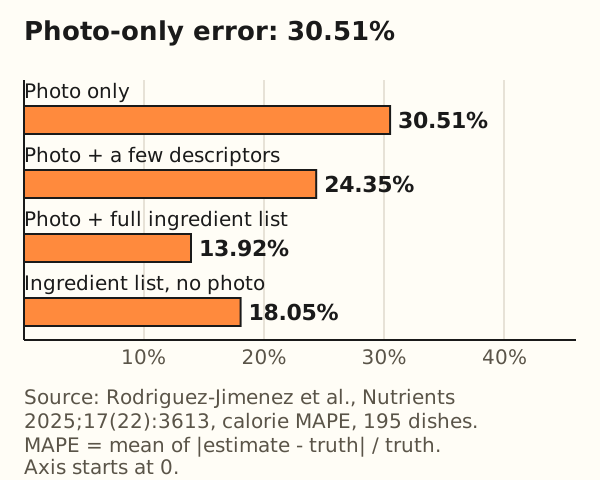
세 가지가 눈에 띄어요:
- 사진에 분량이 적힌 재료 전체 목록을 더하자 오차가 사진만 썼을 때의 46%로 줄었어요(13.92 / 30.51 = 0.456).
- 사진 없이 재료 목록만 준 경우는 18.05%로, 사진만 썼을 때 수치의 59%였어요(18.05 / 30.51 = 0.592). 사진과 목록을 함께 준 경우보다 나빴으므로, 이 시험에서는 사진도 정보를 더했어요.
- 몇 가지 설명어는 효과가 작았어요. 지방 종류, 감미료, 유제품 지방, 고기 종류는 칼로리 오차를 30.51%에서 24.35%로 낮췄고, 6.16 포인트 개선이었어요. 재료 전체 목록은 16.59 포인트를 개선했어요.
가장 오차가 작은 조건인 13.92%도 평균이에요. 한 요리는 그보다 크게 빗나갈 수 있고, 논문은 그릇에 담아 내는 요리일수록 오차가 컸다고 적었어요.
여러분의 식사에 적용할 때의 한계: 모델 하나, 요리마다 한 번 실행, 분량을 적은 상세한 재료 목록. 식탁에서 기억나는 대로 적는 목록은 다른 입력이에요. 이 연구는 Claude나 최신 ChatGPT 버전을 시험하지 않았어요.
단백질, 탄수화물, 지방이 칼로리보다 어려운 이유
같은 논문에서 모든 매크로 오차는 같은 조건의 칼로리 오차보다 컸어요. 12개 비교가 모두 같은 방향이었어요.
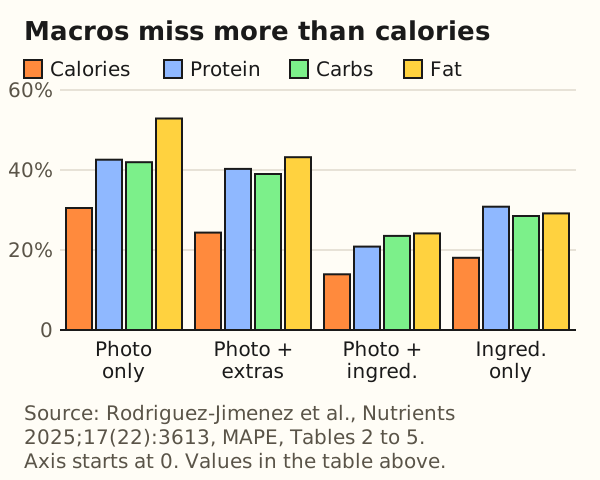
각 매크로 오차를 같은 조건의 칼로리 오차로 나누면 비율이 1.37(사진만, 탄수화물: 41.95 / 30.51)에서 1.77(사진 + 추가 정보, 지방: 43.20 / 24.35) 사이예요. 지방은 네 조건 중 세 곳에서 가장 큰 오차였어요. Mu 벤치마크도 GPT-4.1 mini에서 같은 방향을 보여요. 칼로리 32.7%, 단백질 41.5%, 탄수화물 36.7%, 지방 52.0%.
한 가지 이유는 산술이에요. 칼로리는 세 매크로의 가중합이라서, 일부 매크로 오차가 합계 안에서 서로 상쇄돼요. 지방을 조금 많게, 탄수화물을 조금 적게 추정하는 모델은 칼로리를 맞는 쪽에 가깝게 낼 수 있어요. 그래서 합계가 그 차이를 가리는 만큼, 매크로가 더 나빠 보여요. 이것은 우리의 해석이에요.
실제로 어떤 의미인지는 추적하는 숫자에 따라 달라요.
계산 예시: 단백질 30 g이 들어 있는 요리 하나.
- 사진만, 단백질 MAPE 42.58%:
30 x 0.4258 = 12.8 g- 사진과 재료 목록, 단백질 MAPE 20.85%:
30 x 0.2085 = 6.3 g이것은 요리 한 개당 전형적인 빗나감이지 상한선이 아니에요. 무작위 빗나감은 하루 동안 어느 정도 상쇄돼요. 하지만 항상 분량을 적게 잡는 모델처럼 습관에서 나온 빗나감은 상쇄되지 않아요.
단백질을 목표치에 맞춰 추적한다면, 주요 단백질 식품을 그램 단위로 재고, 채팅이 준 단백질 수치는 대략적인 기준으로만 보세요.
같은 식사를 두 번 물으면 어떻게 될까요
반복 실행이 있는 연구는 Hoang 연구예요. 음식 222개를 각 5번씩 물었고, 변동계수(CV, 다섯 답의 표준편차를 평균으로 나눈 값)를 보고했어요. CV 5%는 답들이 보통 자기 평균의 5% 안에 있다는 뜻이에요.
| 모델과 프롬프트 언어 | 에너지 평균 CV(%) | CV의 표준편차 |
|---|---|---|
| ChatGPT-3.5, 중국어 번체 | 5.17 | 8.68 |
| ChatGPT-3.5, 영어 | 6.19 | 15.23 |
| ChatGPT-4, 중국어 번체 | 5.7 | 7.74 |
| ChatGPT-4, 영어 | 4.74 | 8.39 |
평균 CV는 4.74%에서 6.19%였어요. 저자들은 CV가 10% 미만이었다고 적었어요.
계산 예시: 채팅이 한 식사를 600 kcal라고 답했어요.
- 가장 낮은 평균 CV:
600 x 0.0474 = 28 kcal- 가장 높은 평균 CV:
600 x 0.0619 = 37 kcal새 답은 대략 CV 한 번만큼, 약 570에서 630 kcal 사이로 돌아올 수 있어요. 이것은 실제값과의 차이를 더하기 전, 흩어짐만 본 값이에요.
두 가지 주의점이 있어요. 음식들 사이의 CV 표준편차(7.74에서 15.23 포인트)는 평균 CV보다 커서, 어떤 음식은 평균이 시사하는 것보다 훨씬 크게 달라져요. 논문은 어떤 음식인지 밝히지 않아요. 그리고 이것은 2023년에 날 재료로 한 시험이에요. 현재 버전의 어느 어시스턴트에 대해서도, Claude에 대해서도 반복 실행 데이터는 없어요.
한 번 물어보고 답을 기록하세요. 낮은 숫자를 찾으려고 다시 묻지 마세요. 저장된 기록은 세션마다 바뀌지 않지만, 채팅 답은 바뀌어요.
채팅이 잘하는 일과 혼자서는 못 하는 일
연구는 추정을 측정해요. 기록에는 기억, 추가, 비교도 필요해요. 이 표는 도움말 페이지와 위의 연구, 그리고 대화가 무엇인지에 대한 우리의 판단을 바탕으로 두 가지를 나눠요.
| 작업 | 채팅만으로 | 메모 |
|---|---|---|
| 준 목록 합산하기 | 예 | 줄마다 한 항목씩 요청해서 다시 더해 볼 수 있게 하세요 |
| 레시피나 분량 조정하기 | 예 | 새 합계는 한 번 직접 확인하세요 |
| 단위 바꾸기 | 예 | 컵과 큰술은 음식과 밀도를 밝혀야 해요 |
| 영양 성분표 설명하기 | 예 | 라벨의 글자를 붙여 넣고, 바꿔 말하지 마세요 |
| 빠진 항목 찾기 | 자주 | "뭘 빠뜨렸나요: 기름, 소스, 음료?"라고 물어보세요 |
| 지난 화요일 떠올리기 | 기록으로는 안 됨 | 기억은 식사별 기록이 아니에요 |
| 여러 날의 합계 유지하기 | 아니요 | 합계는 한 스레드 안에만 있어요 |
| 추세 보여 주기 | 아니요 | 기록을 붙여 넣으면 요약해 줘요 |
표 윗부분이 채팅이 제 몫을 하는 곳이에요. 위의 연구가 측정하지 않은 언어 작업이죠. 아래쪽은 기록이 하는 일이에요. 지난 화요일 합계나 주간 평균에는 저장된 구조화 항목이 필요하고, 스레드는 그런 것을 두기에 좋은 장소가 아니에요.
Claude와 ChatGPT: 각 요금제가 추적에 해 주는 일
2026-10-16(미국 기준) Claude 자체 페이지에서 읽은 사실이에요.
- 요금제. Claude Free는 $0이에요. 웹, 데스크톱, 모바일의 채팅, 웹 검색, 대화 간 메모리, 앱 연결을 포함해요. 사용량은 5시간 롤링 창으로 초기화되고, 페이지에는 고정 메시지 수가 없다고 나와요(Claude 요금제).
- 메모리. 메모리는 Free, Pro, Max에서 기본으로 켜져 있어요. Claude는 기본적으로 민감하다고 분류한 주제를 저장하지 않고, 건강은 목록에 있는 예시예요. “Settings”(설정) > “Memory”(메모리)에서 “Include sensitive topics in memory”(메모리에 민감한 주제 포함)를 켤 수 있어요. 식사 일기가 건강으로 분류되는지는 Claude가 정하며, 우리는 시험하지 않았어요(Claude 도움말: 채팅 검색과 메모리).
- 삭제. 대화를 삭제해도 그 대화에서 만들어진 메모리 항목은 지워지지 않아요. “Reset memory”(메모리 초기화)는 모든 메모리를 지워요.
- 검색. 지난 채팅 검색은 유료 요금제 기능이에요.
- 커넥터. 무료 사용자는 커스텀 커넥터를 하나 추가할 수 있어요(Claude 도움말: 커스텀 커넥터).
ChatGPT의 현재 요금제 한도나 메모리 동작은 확인하지 못했어요. 2026-10-16에 OpenAI 도움말 페이지를 열 수 없었으므로 그에 대해서는 주장하지 않아요. 의존하기 전에 직접 확인하세요.
채팅 기록은 식사 기록이 아니에요
한 달 동안 한 스레드에서 식사를 기록한다고 가정해 보세요. 세 가지가 잘못되는데, 셋 다 추정 품질과는 관계없어요.
- 스레드를 넘는 합계가 없어요. 새 채팅은 메모리나 검색이 가져오지 않는 한 어제의 스레드 없이 시작해요. 그래도 메모리는 채팅 사이에 맥락을 이어 줄 뿐, 장부라고 설명된 것은 찾지 못했어요.
- 수정이 추적되지 않아요. 12일째에 "밥은 절반으로 해 줘"라고 말하면, 앞선 답은 스크롤 안에 그대로 남아요. 어느 숫자가 최신인지는 여러분이 판단해야 해요.
- 검색은 스크롤이에요. "지난 화요일에 뭘 먹었지?"를 찾으려면 메시지를 거슬러 읽어야 해요. Claude 무료 요금제에서는 지난 채팅 검색을 쓸 수 없어요.
식사 기록에는 고정된 칸이 있어요. 날짜, 끼니, 항목, 그램, 칼로리, 단백질, 탄수화물, 지방. 항목마다 현재 값이 하나이고, 합계는 항목에서 계산돼요. 스레드에는 이런 것이 없어요. 아래 그림은 빠진 부분을 채우는 흐름이에요. 채팅이 추정을 하고, 별도의 층이 각 식사를 확인하고 보관해요.
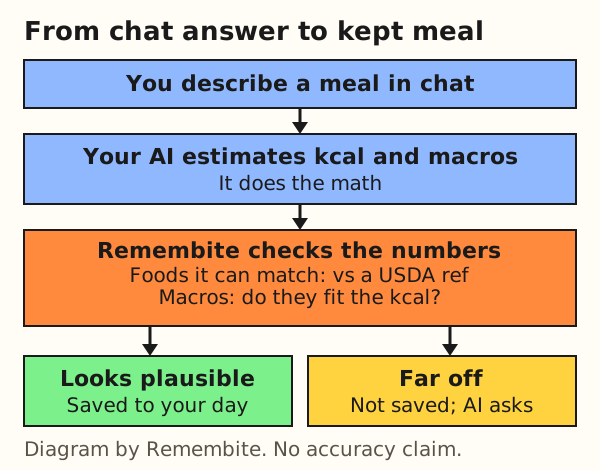
스프레드시트나 아무 기록 앱도 같은 일을 해요. 세 가지 방법(AI에게 묻기, 찾아보기, 기록 유지)을 비교하려면 AI에게 칼로리를 묻거나, 찾아보거나, 기록할까?를 보세요.
다섯 단계로 하는 실천 설정
이 루틴은 연구에서 나왔어요. 모델에 분량을 주고, 모호함을 없애고, 숫자 하나를 확인하고, 결과를 저장하세요.
- 무게를 재거나, 그램으로 말하세요. 연구에서 오차가 가장 작았던 조건은 분량이 적힌 재료 전체 목록이었어요. 저울이 있으면 그런 분량을 얻을 수 있어요. 잴 수 없다면 그렇다고 말하고 "큰 달걀 2개"처럼 개수를 주세요.
- 익힌 상태인지 날것인지 말하세요. Hoang의 프롬프트는 날것 음식을 요청했어요. 같은 음식도 상태에 따라 값이 다르다는 뜻이에요. "쌀 150 g"이 아니라 "익힌 흰쌀 150 g"이라고 말하세요.
- 항목별 숫자를 요청하세요. 항목마다 한 줄씩, 그램, 칼로리, 단백질, 탄수화물, 지방을 적으세요. 합계 하나만 보면 어느 항목이 벗어났는지 가려져요. 프롬프트 문구는 ChatGPT로 칼로리를 계산하는 방법에 있어요.
- 숫자 하나를 USDA와 대조하세요. 칼로리가 가장 많은 항목을 골라 FoodData Central에서 다시 계산하세요. 방법은 AI 칼로리 추정을 확인하는 방법에 있어요.
- 합계는 다른 곳에 보관하세요. 같은 날 항목별 줄을 스프레드시트, 메모 파일, 기록 앱에 옮기세요.
4단계를 그럴듯한 한 그릇에 적용해 볼게요. 값은 USDA SR Legacy 데이터예요(FoodData Central 다운로드, 2026-10-16 기준).
계산 예시: 구운 닭가슴살 150 g, 익힌 흰쌀 150 g, 삶은 브로콜리 100 g, 올리브유 10 g.
- 닭고기(FDC 171477, 100 g당 165 kcal):
150 x 165 / 100 = 247.5 kcal- 쌀(FDC 168878, 100 g당 130 kcal):
150 x 130 / 100 = 195 kcal- 브로콜리(FDC 169967, 100 g당 35 kcal):
100 x 35 / 100 = 35 kcal- 올리브유(FDC 171413, 100 g당 884 kcal):
10 x 884 / 100 = 88.4 kcal- 합계:
247.5 + 195 + 35 + 88.4 = 565.9 kcal채팅이 이 그릇을 700이라고 하면, 어느 항목을 높게 셌는지 물어보세요. 기름이 흔한 원인이에요. 10 g은 88 kcal이므로 기름을 조금 더 부으면 금방 쌓여요.
USDA 값은 그 음식의 전형적인 표본에 대한 기준이에요. 여러분의 닭고기가 아니에요. 작은 차이는 정상이에요. 큰 차이는 AI에게 무엇을 가정했는지 물어볼 이유가 돼요.
Remembite가 들어서는 자리
AI가 계산하고, Remembite가 기록을 보관해요. 어시스턴트가 한 끼의 칼로리, 단백질, 탄수화물, 지방을 계산해요. Remembite는 식사를 저장하고, 날마다 합계를 내고, 기록을 차트로 보여 줘요. "내 오트밀"처럼 여러분이 이름 붙인 음식도 기억할 수 있어요.
저장하기 전에 Remembite는 확실하게 맞춰 볼 수 있는 각 음식을 USDA 기반 기준값과 비교하고, 단백질, 탄수화물, 지방이 칼로리와 맞는지 확인해요. 숫자가 많이 벗어나 보이면 Remembite는 저장하지 않아요. 대신 어시스턴트에게 질문을 돌려보내고, 어시스턴트가 여러분에게 확인하거나 고쳐 달라고 물어요.
Claude 커넥터는 지금 쓸 수 있어요. Claude에서 "Customize"(사용자 정의) > "Connectors"(커넥터)를 열고 https://remembite.com/mcp를 추가하세요. Remembite는 ChatGPT에서도 작동해요(beta, 개발자 모드 사용). 단계별 안내는 Claude 또는 ChatGPT에 있고, Claude로 식사를 기록하고 숫자를 지키는 방법도 읽어 보세요. 주요 AI 칼로리 도구 종류가 어떻게 다른지는 가이드에서 볼 수 있어요. 샘플 대시보드는 샘플 데이터로 화면 구성을 보여 주며 계정이 필요 없어요.
한계: Remembite에는 바코드 스캐너가 없어요(AI가 Open Food Facts에서 바코드 번호를 찾아볼 수 있어요). 자체 식사 사진 인식과 기기 동기화도 없어요. 확인 기능은 많이 벗어나 보이는 숫자를 표시할 뿐이고, 추정치를 더 가깝게 만들지는 않아요. 채팅 추정과 비교한 결과도 공개하지 않았어요. 매칭되지 않는 음식은 어시스턴트가 보낸 그대로 저장돼요. 시작은 무료예요. 유료 요금제는 시작 전에 여기에서 알려 드릴게요.
자주 묻는 질문
칼로리 계산에는 ChatGPT와 Claude 중 어느 쪽이 더 나은가요?
순위를 매기지 않아요. Rodriguez-Jimenez와 Hoang 연구는 ChatGPT만 시험했어요. Fridolfsson은 두 모델을 사진으로 시험했고, 2024년 중반 버전에서 같은 35.8% 칼로리 오차를 측정했어요. 글로 쓴 식사 설명으로 현재 버전을 비교한 연구는 찾지 못했어요.
사진을 읽을 수 있나요?
읽을 수는 있지만 크게 빗나가요. 사진만으로 ChatGPT-5는 30.51%, 통제된 위에서 찍은 사진에서 GPT-4.1 mini는 32.7%, Claude 3.5 Sonnet은 35.8%의 오차를 보였어요. 분량이 적힌 재료 목록을 더하자 ChatGPT-5의 오차는 13.92%로 줄었어요.
음식을 무게로 재야 하나요?
아니요. 하지만 연구에서 오차를 움직인 것은 분량이었어요. 가장 오차가 작은 조건은 분량이 적힌 재료 목록이었어요. 잴 수 없다면 개수와 크기를 주고, 숫자를 범위로 보세요.
어제 먹은 것을 기억하나요?
가끔, 느슨하게요. Claude 메모리는 Free, Pro, Max에서 기본으로 켜져 있고, 직접 켜지 않으면 건강 주제를 저장하지 않아요. 맥락은 이어 주지만 식사별 기록은 아니고, 지난 채팅 검색에는 유료 요금제가 필요해요. ChatGPT의 동작은 확인하지 못했어요.
이것은 의학적 조언인가요?
아니요. 이것은 식품을 기록하기 위한 추정이며, 건강이나 어떤 질환에 대한 조언이 아니에요. 그런 조언은 의사나 등록된 영양사에게 구하세요.
보관된 기록이 어떻게 보이는지 보기
샘플 대시보드를 열면 샘플 데이터로 "Today"(오늘), "History"(기록 보기), "My foods"(내 음식)를 볼 수 있어요. 직접 기록을 남기려면 무료 계정을 만드세요. Remembite는 Anthropic, OpenAI, Google과 제휴하지 않아요.
추정치이며 의학적 조언이 아니에요. 숫자가 작동하는 방식.